Applied AI research
面向电网规划与大型负荷的多智能体 AI 平台
四类专家智能体自己跑电网仿真、检索技术与法规知识库,每个回答都要检查其中的数值能否追溯到工具结果。
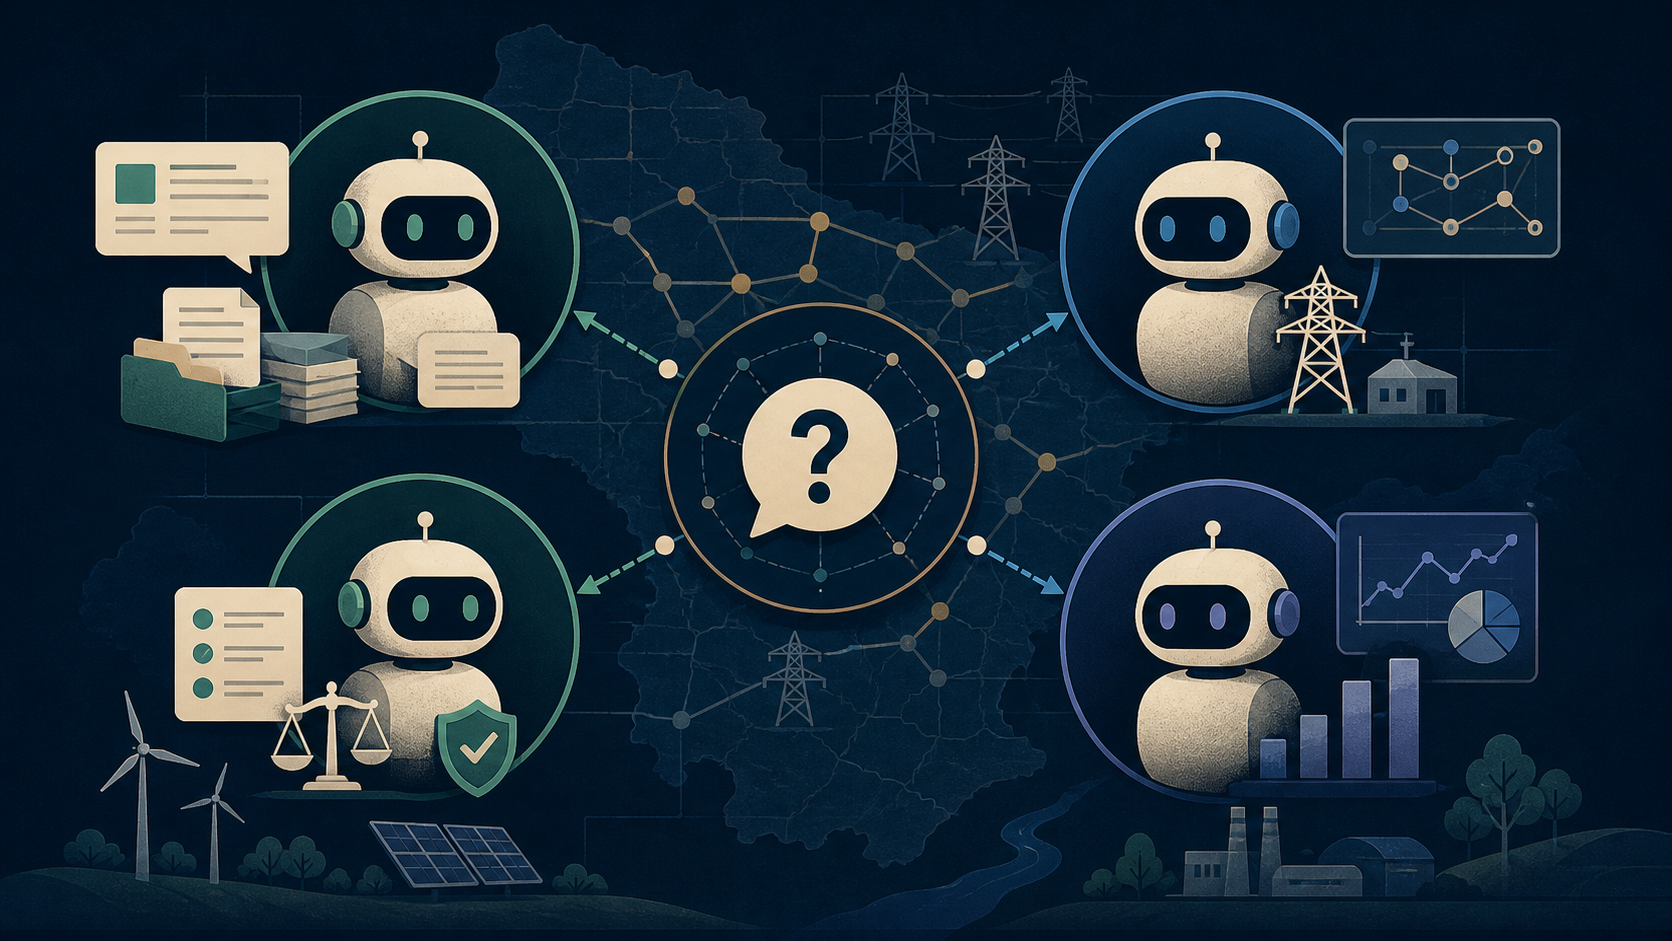
封面插图由 AI 生成
系统架构
先做计划,再把任务交给对口的专家
问题
一个大型负荷接入申请,比如数据中心要几百兆瓦,会牵出一连串没有任何单一专家能独立回答的问题:它在并网排队中排在什么位置、会触发哪些电网升级、适用哪套监管流程、负荷通电之后系统的逐小时运行会变成什么样。答案分散在排队数据、规划研究、电价文件和生产模拟模型里,把它们拼起来往往要几周的专家时间。而在这几周里,排队还在变长。
我做了什么
我搭建了一个多智能体 AI 助手,用来支持电网规划和大型负荷接入,重点是 AI 数据中心选址。编排智能体把规划问题转成结构化的研究计划,找出缺失的假设,再把任务分派给四类专家智能体,分别负责并网、电力系统分析、仿真计算和政策法规。
这些智能体使用基于 pandapower 的工程工具,做潮流、N-1 校核、短路电流和站点筛选分析。通过模型上下文协议(MCP),它们拿到的是结构化的仿真结果,因此可以调整假设、重新运行分析,并比较不同的并网方案。比如求一个母线最多能接多大负荷,就是围绕潮流是否仍然收敛做搜索。系统还用混合检索和 GraphRAG 从技术知识库中查找相关内容,覆盖 94 份技术与法规文件。
为了检验这个系统能否完成一项已发表的研究,而不只是回答零散的问题,我用它在 RTS-GMLC 测试电网上复现了 Kim 等人(Nature Communications,2026)的站点筛选方法。在全部 73 个母线上,接受可中断供电让合格站点数量在 300 MW 和 900 MW 两个规模下都增加了 22%,方向和幅度都与论文在 2,000 节点德州电网上报告的结果一致。复现过程还暴露了一个度量问题:即使完全不接数据中心,这个测试电网的 105 个单一线路故障中也已有 37 个出现越限,用绝对通过率会因为与新负荷无关的原因否掉所有站点。所以系统改为把每个站点和不加负荷的同一电网作对比,这才是并网研究真正要回答的问题。
每次分析都会留下一份可追溯的记录,包括工具调用、假设和结果,便于审查建议、发现没有完成的检查,并用修改后的输入重新运行研究。
这个平台的前身是 GRID-FORGE 原型,原型用基于规则的路由器分派任务。现在的版本用一个会做计划的编排智能体取代了它,能够协调多步骤的分析流程。
演示内容
视频完整演示了一次数据中心并网研究,从最初的提问到最后的建议。一家开发商计划在加州建设一个 2,000 机柜的 AI 数据中心园区,估算设施负荷为 249.6 MW,并且可以接受可中断供电。编排智能体制定研究计划,协调各专家智能体筛查 RTS-GMLC 测试电网的 73 个母线,然后在三个入围站点做交流潮流和 N-1 故障分析。
监控面板在整个流程中跟踪研究计划、各智能体的工作、研究假设和缺失的输入。电网缺少短路分析所需的电源阻抗数据时,工具会明确指出这一限制,而不是给出一个没有依据的结果。
我如何验证结果
可靠的工程分析,不能只靠 AI 给出听起来合理的解释。我搭建了一个确定性的评估框架,用记录下来的执行轨迹来检查智能体的分析过程是否合理、能否核查。
这个框架对每次分析检查五个方面:工程数值是否有仿真输出作支撑,任务是否分派得当,检索到的来源是否被引用,新增负荷是否和基准电网状态做了比较,智能体是否根据仿真反馈改进了分析。
这些检查能帮助发现没有依据的结论、没有执行完的工具调用,以及前后不一致的分析流程。我还用评估结果比较不同的模型配置、监控运行成本,在表现相当的任务上改用计算量更小的模型。
这个评估衡量的是分析过程的可追溯性和一致性,并不保证每个工程结论都正确。最终结果仍然需要领域上的验证和工程判断。
局限
这个平台用来辅助专业的电力系统规划和工程判断,而不是取代它们。目前的仿真使用 RTS-GMLC 等公开测试电网,而不是电力公司自己的电网模型。缺少关键输入时,比如短路计算需要的电源阻抗数据,系统会明确指出这一限制,而不会给出没有依据的估算。
基于文档的回答质量,还取决于技术知识库的覆盖范围和时效性。因此,这个平台最适合做初步的并网筛选和情景探索;详细的并网研究和最终的工程决策还需要进一步验证。